このインテグレーションは、Treasure AIからBatchへデータを直接エクスポートします。Batchは、モバイルプッシュ、Webプッシュ、アプリ内メッセージング、メール、SMSにわたるオムニチャネルキャンペーンのための顧客エンゲージメントプラットフォーム(CEP)です。これは2つのターゲットを持つ1つのコネクタです。target: Profile(デフォルト)を設定するとProfile Mass Update APIを通じてBatchプロファイルを更新し、target: Audienceを設定するとAudience APIを通じてセグメントメンバーシップをBatchオーディエンスにプッシュします。
このインテグレーションは、各クエリ結果の行をBatchの操作にマッピングします。識別子、ネイティブ属性、カスタム属性、イベントはすべて、クエリ内の列名プレフィックス規約で宣言されるため、列ごとの設定は不要です。Profileモードでは、Attributes同期(1行で1プロファイルを更新)またはEvents同期(1行で1イベントを記録し、識別子ごとにグループ化)を実行できます。Audienceモードでは、1行が1つのオーディエンスメンバーシップエントリにマッピングされます。2つのターゲットの比較については、ターゲットマッピングの概要を参照してください。
- Treasure AIの基本的な知識。
- Batchのプロファイル、custom ID、installation識別子、ネイティブ属性、イベントに関する基本的な知識。
- Batch REST APIキー。
- Batchプロジェクトキー。
identifier__列名プレフィックスで必要な識別子列を公開するクエリ:target: Profileの場合:identifier__custom_id、またはidentifier__apikeyとidentifier__installation_idの組み合わせ。target: Audienceの場合:identifier__id。
セキュリティポリシーで IP ホワイトリストが必要な場合は、接続を成功させるために Treasure Data の IP アドレスを許可リストに追加する必要があります。
リージョンごとに整理された静的 IP アドレスの完全なリストは、次のリンクにあります: IP Addresses for Integrations
- 配列値の属性はすべて置換専用です。
string_array__カスタム属性と$topic_preferencesは常に完全な配列として送信されます。Batch APIは増分操作をサポートしていますが、このバージョンでは増分の$add/$remove操作はサポートされていません。クエリで目的の配列全体を出力する必要があります。 batch__プレフィックスのオプトアウトはありません。batch__regionという名前の列は常にネイティブの$region属性にマッピングされます。代わりにカスタム属性として送信するには、プレフィックスのない名前に列をエイリアスしてください。- Profile Mass Update API(
target: Profile)は、受理応答またはエラー応答を即座に返し、オーディエンス形式のインデックストークンやポーリングフローは提供しません。Audience API(target: Audience)はインデックストークンを返し、ポーリングをサポートします。その動作については、オーディエンスのインデックス作成とポーリングを参照してください。両者を混同しないでください。 - スループット(1秒あたり10,000プロファイル更新)はクライアント側で能動的にスロットリングされません。
429応答のみがバックオフをトリガーします。 - 列名は自動的に小文字に正規化されるため、大文字や大小文字が混在した名前も受け付けられます。小文字化した後でも
^[a-z0-9_]{1,30}$に一致しない名前(例:ハイフンやドットを含む、または30文字を超える名前)は、クエリでエイリアスする必要があります。大小文字の変換以外の実行時のリネームはサポートされていません。 - レート制限(
429)とサーバーエラー(5xx、ネットワークタイムアウト)は指数バックオフで再試行されます。400と401応答は、ペイロードまたは認証の問題を示すため、即座に失敗します。 Audienceモードには部分エラーの概念がありません。BatchはオーディエンスのエラーをトップレベルのHTTPステータスとしてのみ報告します。ignore_partial_errorsは適用されません。
Treasure AIでは、クエリを実行する前にデータ接続を作成して設定する必要があります。データ接続の一部として、Batchにアクセスするための認証を提供します。
- TD Consoleを開きます。
- Integrations Hub > Catalogに移動します。
- Catalogの右端にある検索アイコンをクリックして、Batchと入力します。
- Batchコネクタにカーソルを合わせて、Create Authenticationを選択します。
New Authenticationダイアログが開きます。
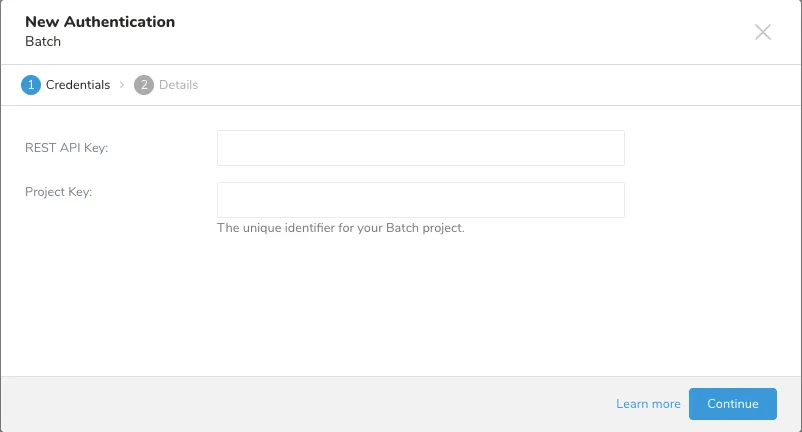
- BatchのREST API Keyを入力します。
- BatchのProject Keyを入力します。
- 接続の名前を入力します。
- Continueを選択します。
| パラメータ | 必須 | 説明 |
|---|---|---|
rest_api_key | はい | Batch REST APIキー。 |
project_key | はい | Batchプロジェクトキー。 |
インテグレーションを設定するには:
- TD Consoleを開きます。
- Data Workbench > Queriesに移動します。
- New Queryをクリックしてクエリを作成するか、エクスポートしたい保存済みクエリを開きます。
- クエリエディタの上部で、Export Resultsを選択します。
- 作成したBatch認証を選択します。
- エクスポートパラメータを設定します。
- 列プレフィックスの検出:インテグレーションは各クエリ結果の列名を検査し、識別子(
identifier__)、ネイティブ属性(batch__)、型プレフィックス付きカスタム属性(date__、url__、string_array__、object__、array__)、またはプレーンなカスタム属性(プレフィックスなし、Embulkの列型から型を推論)に分類します。 - 識別子の抽出:
Profileモードでは、インテグレーションは各行についてidentifier__値を読み取り、custom_idまたはinstallation形式(apikey+installation_id)を使用してidentifiersブロックを構築します。Audienceモードでは、identifier__idを読み取り、ids[]エントリを構築します。 - 属性またはイベントのマッピング:
Attributesモードでは、ネイティブ列は予約された$…ワイヤキーで出力され、カスタム列はラップされたキーまたはプレーンキーで出力されます。Eventsモードでは、各行が1つのイベントを構築し、イベントは識別子ごとにevents[]配列にグループ化されます。Audienceモードでは、各行の識別子以外の列がids[].attributesになります。 - 行ごとの検証:インテグレーションは、送信前にキー形式、値の制限、ネイティブ属性の型、および25 kBのシリアライズされた属性サイズを検証します。
- バッチ処理:操作はバッファリングされ、バッチ単位(最大
batch_size、リクエストあたり最大10,000操作)でフラッシュされます。 - 再試行と応答処理:
429およびサーバーエラーはバックオフで再試行されます。Profileモードでは、BatchのSUCCESS_WITH_PARTIAL_ERRORS応答はignore_partial_errorsに従って処理されます。Audienceモードでは、非同期のインデックストークンがオーディエンスのインデックス作成設定に従ってポーリングされます。
コネクタには、条件付きフィールドを持つ単一の設定サーフェスがあります。適用対象列は、パラメータが両方のターゲットに共通か、ProfileまたはAudienceに固有かを示します。
| パラメータ | 適用対象 | 必須 | デフォルト | 説明 |
|---|---|---|---|---|
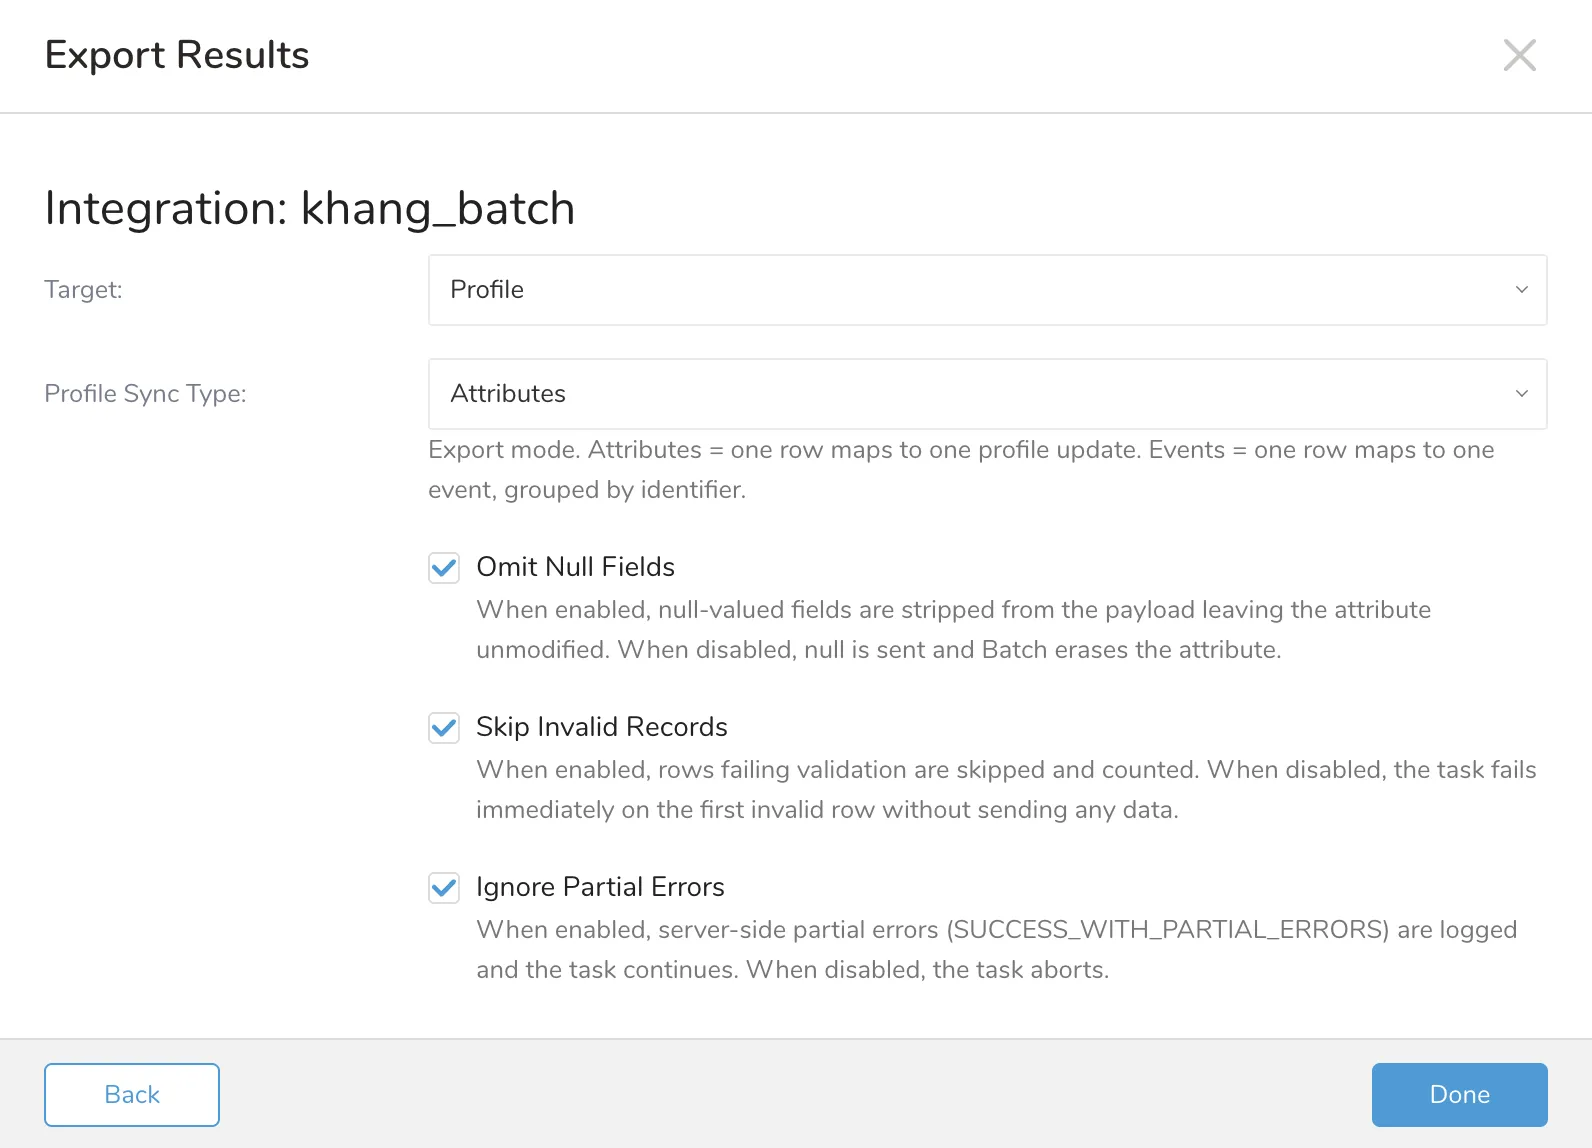
target | 共通 | いいえ | Profile | Profile(Profile Mass Update API)またはAudience(Audience API)。APIとマッピングを選択します。不明な値は設定エラーになります。 |
batch_size | 共通 | いいえ | 10000 | リクエストあたりの操作数。1から10000までの整数である必要があります。0または10000を超える値は設定エラーになります。 |
skip_invalid_records | 共通 | いいえ | true | trueの場合、クライアント側の検証に失敗した行はスキップされ、ログに記録され、カウントされ、有効な行は続行されます。falseの場合、最初の無効な行でタスクが失敗し、何も送信されません。 |
omit_null_fields | Profileのみ | いいえ | true | trueの場合、null値のフィールドはペイロードから除去され、属性は変更されません。falseの場合、nullフィールドはJSON nullとして出力され、Batchは属性を消去します。target: Audienceの場合は無視されます(null属性のセルは常に省略されます)。null値の処理を参照してください。 |
profile_sync_type | Profileのみ | いいえ | Attributes | エクスポートモード。Attributesは1行を1プロファイル更新にマッピングします。Eventsは1行を1イベントにマッピングし、識別子ごとにグループ化します。target: Audienceの場合は無視されます。 |
ignore_partial_errors | Profileのみ | いいえ | true | Batchのサーバー側SUCCESS_WITH_PARTIAL_ERRORS応答のみを制御します。trueの場合、レコードごとのエラーがログに記録され、タスクは続行されます。falseの場合、タスクは中止されます。target: Audienceの場合は無視されます。 |
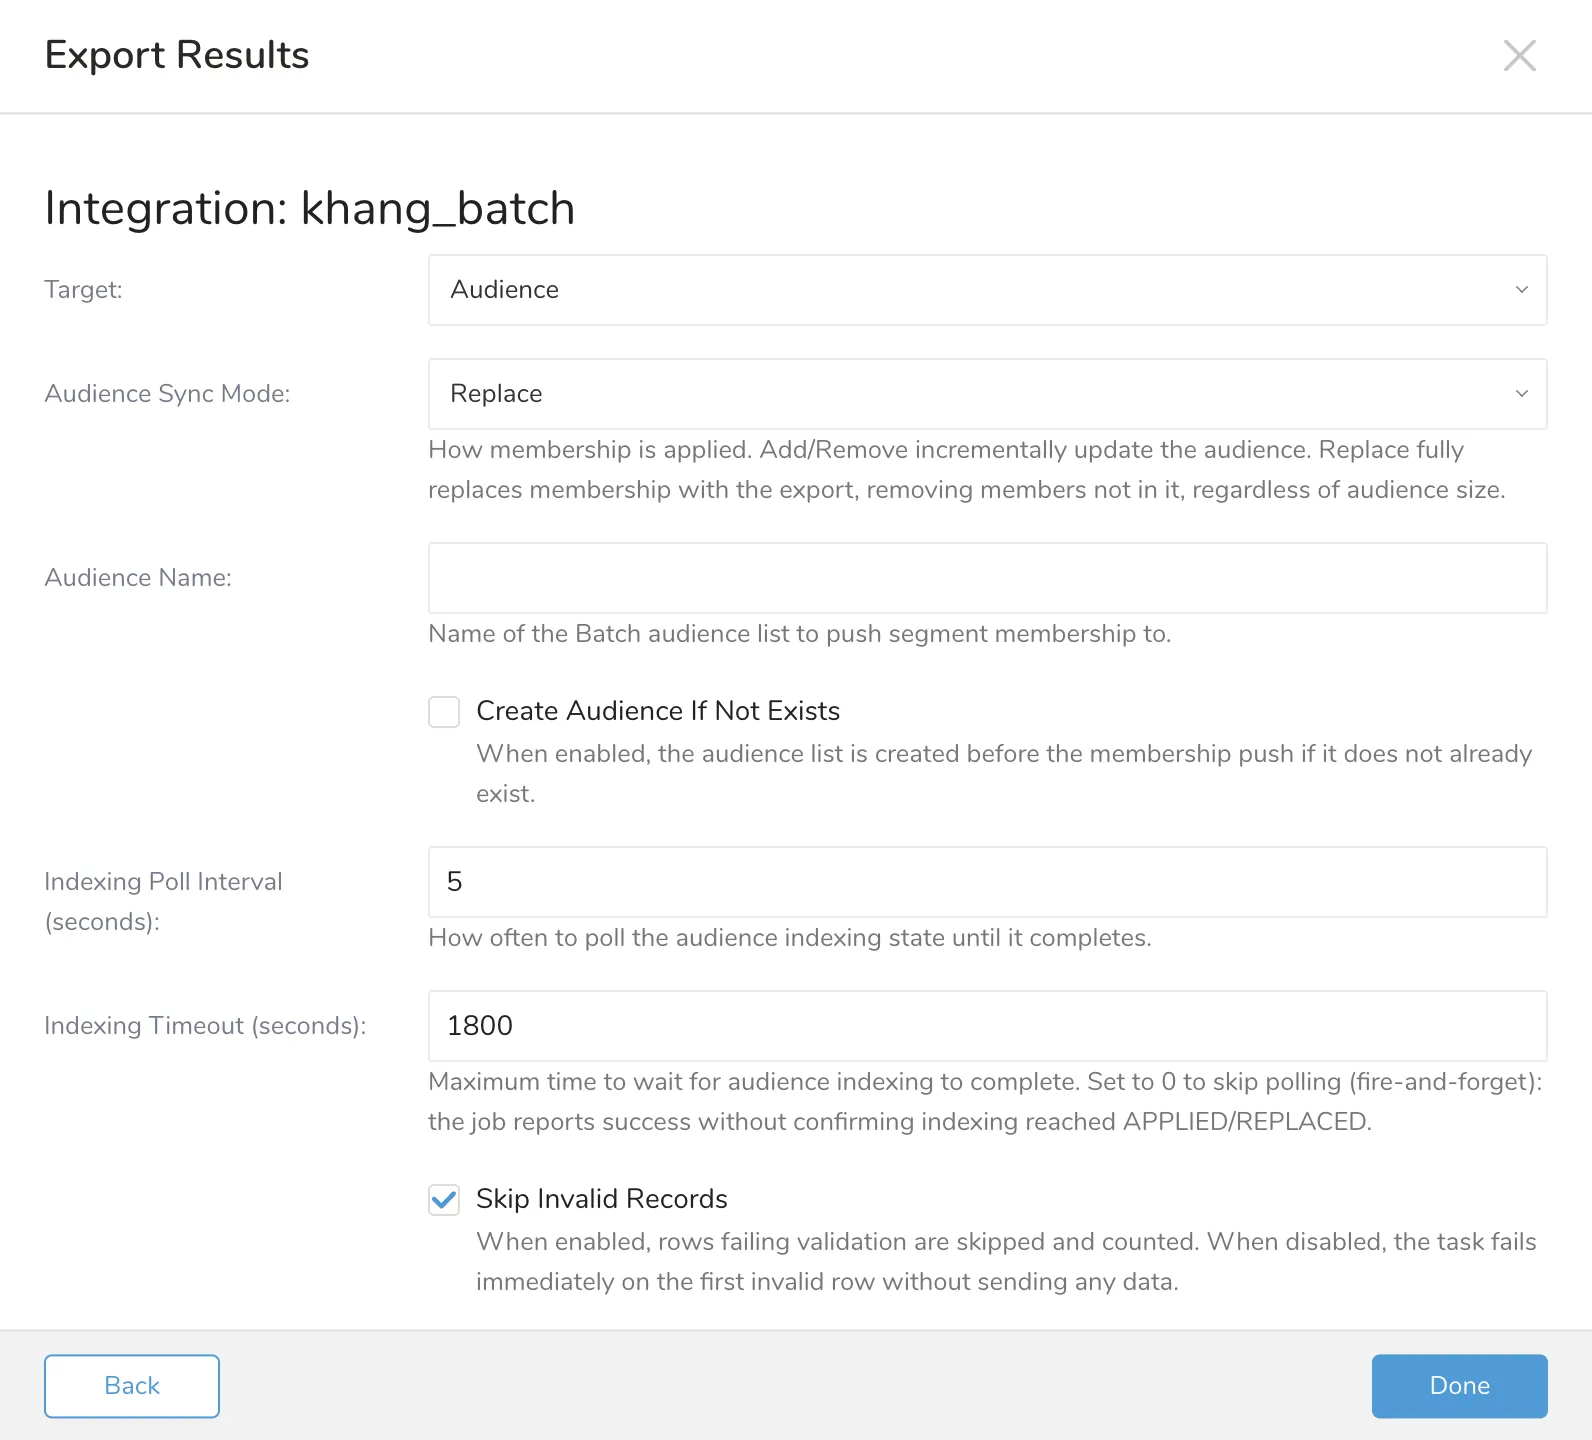
audience_name | Audienceのみ | はい | — | Batchオーディエンスの名前。^[A-Za-z0-9_-]{1,255}$に一致する必要があります。 |
audience_sync_mode | Audienceのみ | いいえ | replace | add | remove | replace。オーディエンス同期モードを参照してください。 |
create_audience_if_not_exists | Audienceのみ | いいえ | false | trueの場合、ジョブはオーディエンスが存在しない場合に最初にそれを作成し(POST /audiences/create)、その後メンバーシップをプッシュします。falseの場合、オーディエンスが存在しないとジョブは失敗します。 |
audience_type | Audienceのみ | 条件付き | — | create_audience_if_not_exists: trueの場合は必須。custom_ids | emails | install_ids。作成時にのみ使用されます。 |
audience_display_name | Audienceのみ | いいえ | — | オプションの表示名。作成時にのみ使用されます。 |
indexing_poll_interval_secs | Audienceのみ | いいえ | 5 | GET /audiences/viewポーリング間の秒数。 |
indexing_timeout_secs | Audienceのみ | いいえ | 1800 | インデックス作成の完了を待機する秒数。0はfire-and-forgetを意味します。ジョブは、メンバーシッププッシュが終端のインデックス状態に達したことを確認せずに即座に成功を報告します。 |
targetがProfileの場合はこの設定を使用します。
targetがAudienceの場合はこの設定を使用します。
識別子と属性の型は、クエリ結果スキーマの列名プレフィックスで宣言されます。列の設定は不要です。
列名は大小文字を区別せずにマッチングおよびシリアライズされます。インテグレーションはプレフィックスを検出してBatchのワイヤキーを導出する前に各列名を小文字化するため、IDENTIFIER__Custom_Id、BATCH__Email_Address、プレーンなLoyaltyTierはそれぞれidentifier__custom_id、batch__email_address、loyaltytierとして扱われます。そのため、カスタム属性キーは常に小文字でBatchに送信されます(Batchはカスタムキーが^[a-z0-9_]{1,30}$に一致することを要求します)。Eventsモードでは、batch__nameの値も検証および送信の前に小文字化されるため、Purchase_Completedはpurchase_completedになります。
| 領域 | Profileターゲット | Audienceターゲット |
|---|---|---|
| 入力行 | 1プロファイル更新(Attributes)または1イベント(Events)。 | 1オーディエンスidエントリ。 |
| 必須の識別子 | identifier__custom_id、またはinstallation識別子(identifier__apikey + identifier__installation_id)。 | identifier__id。 |
| カスタム属性の上限 | プロファイルあたり50属性。 | idあたり15属性。 |
| 同期オプション | profile_sync_type(Attributes | Events)。 | audience_sync_mode(add | remove | replace)。 |
| APIの動作 | 成功/部分エラーを含むProfile Mass Update応答。 | インデックストークンのポーリングを伴う非同期Audience API。 |
同じプレフィックスモデルが両方のターゲットに適用されますが、各プレフィックスは意味をなす場所でのみ受け付けられます。あるターゲットで拒否される列は、エクスポート時に設定エラーになります。
| 列パターン | Profileターゲット | Audienceターゲット |
|---|---|---|
identifier__custom_id | プロファイル識別子 → identifiers.custom_id。文字列、最大512文字。 | 拒否されます。identifier__idを使用してください。 |
identifier__apikey + identifier__installation_id | installation識別子 → identifiers.installation.apikeyおよびidentifiers.installation.installation_id。両方の列が一緒に存在する必要があります。 | 拒否されます。identifier__idを使用してください。 |
identifier__id | 拒否されます。 | オーディエンスメンバーid → ids[].id。必須。null または空の場合、行は(skip_invalid_recordsに従って)拒否されます。 |
batch__<name> | ネイティブプロファイル属性(Attributes)→ $<name>、またはイベント予約フィールド(Events)。Profile固有の注意事項を参照してください。 | 拒否されます。ネイティブプロファイル属性とイベントはオーディエンスではサポートされていません。オーディエンスのアクションはaudience_sync_modeから決まります。 |
date__<name> | カスタム日付属性 → date(<name>)。値はエポック秒またはRFC 3339文字列です。 | オーディエンス属性 → attributes."date(<name>)"。同じ値のルール。 |
url__<name> | カスタムURL属性 → url(<name>)。値にはスキーム(://)が含まれ、最大2048文字である必要があります。 | オーディエンス属性 → attributes."url(<name>)"。同じ値のルール。 |
string_array__<name> | カスタム文字列配列属性(置換専用)→ <name>。空でない文字列のJSON配列、各項目最大300文字、最大25項目。 | 拒否されます。コンテナプレフィックスはオーディエンスではサポートされていません。 |
object__<name> / array__<name> | カスタムオブジェクトまたは配列属性 → <name>。セルは整形式のJSONオブジェクトまたは配列文字列である必要があります。 | 拒否されます。コンテナプレフィックスはオーディエンスではサポートされていません。 |
<name>(プレフィックスなし) | カスタム属性 → <name>。Embulkの列型から型が推論されます。キーは^[a-z0-9_]{1,30}$に一致する必要があります。 | オーディエンス属性 → attributes.<name>。Embulkの列型から型が推論されます。 |
Attributesモードでサポートされるbatch__ネイティブ属性名は、email_address、email_marketing、phone_number、sms_marketing、email_open_tracking_consent、language、timezone、region、topic_preferencesです。Eventsモードでは、batch__プレフィックスは代わりに予約済みイベントフィールドname(必須)、time、label、tagsを保持します。ネイティブ属性セットはprofile_sync_typeによってゲートされます。プロファイルネイティブ名はEventsモードで拒否され、イベント予約名はAttributesモードで拒否されます。
コネクタは、プレーンな(プレフィックスなしの)カスタム属性のBatch型をTreasure AIの列型から推論します。
| Treasure AIタイプ | Batchデータタイプ |
|---|---|
string | string |
long | number |
double | number |
boolean | boolean |
timestamp | date__<name>を使用してBatchのdate(<name>)属性として送信します。 |
オーディエンスモードでは、単一の識別子列identifier__idを使用します。Profileの識別子サフィックス(identifier__custom_id、identifier__apikey、identifier__installation_id)は、このモードでは拒否されます。profile_sync_typeとignore_partial_errorsも無視されます — オーディエンスにはEventsモードや部分エラーの概念がありません。
識別子以外のすべての列はids[].attributesの下のカスタム属性になり、1つのidあたり最大15属性(プロファイルの50に対して)に制限されます。サポートされるのはスカラープレフィックスdate__、url__、およびプレーン(プレフィックスなし)のみです。コンテナプレフィックスstring_array__、object__、array__はサポートされておらず、設定エラーになります。ネイティブプロファイル属性とイベントはオーディエンスには適用されないため、このモードではbatch__プレフィックスはサポートされていません — batch__列が存在すると設定エラーになります。アクションは完全にaudience_sync_modeから決まります。
create_audience_if_not_exists: trueの場合、ジョブはまずオーディエンスが存在するかどうかを確認し、メンバーシップをプッシュする前にそれを作成します(POST /audiences/create、audience_typeとオプションのaudience_display_nameを使用)。falseの場合、オーディエンスが存在しないとジョブは失敗します。
このモードではomit_null_fieldsは適用されません。Batch Audience APIはnull属性を拒否するため、この設定に関わらずnull属性のセルは常にペイロードから省略されます。
omit_null_fieldsパラメータは、Profileモードでnull値のセルの送信方法を制御します。Audienceモードでは効果がありません — Batch Audience APIはnull属性を拒否するため、この設定に関わらずnull属性のセルは常に省略されます。
omit_null_fields | 動作(Profileモード) |
|---|---|
true | null値のフィールドはクライアント側で除去され、Batchプロファイルの属性は変更されません。 |
false | null値のフィールドはJSON nullとして出力され、Batchは属性を消去します。型付きのdate__/url__属性の場合、削除のためにプレーンなアンラップキーが出力されます。 |
profile_sync_type | 動作 |
|---|---|
Attributes | 1つの入力行を1つのプロファイル更新にマッピングします。ネイティブ属性とカスタム属性がプロファイルに書き込まれます。 |
Events | 1つの入力行を1つのイベントにマッピングします。イベントは識別子ごとにevents[]配列にグループ化されます。フラッシュ前に識別子ごとに最大15イベントが蓄積されます。 |
audience_sync_mode | エンドポイント | 動作 |
|---|---|---|
add | POST /audiences/update(すべてのバッチ) | 各idをオーディエンスに追加します。ids[].action: "add"。 |
remove | POST /audiences/update(すべてのバッチ) | 各idをオーディエンスから削除します。ids[].action: "remove"。 |
replace | POST /audiences/replace(バッチ1)+ POST /audiences/update(バッチ2..N、action: "add") | あらゆる規模でのフルセグメント置換。最初のバッチは既存のメンバーシップをすべて(以前の規模に関わらず)消去し、バッチ1でシードします。コネクタは、継続の追加バッチを送信する前にバッチ1のreplaceインデックストークンを完了までポーリングするため、非同期の消去処理が競合して追加されたばかりのバッチを消去することはありません(オーディエンスのインデックス作成とポーリングを参照)。セグメントがbatch_sizeを超える場合、以降のバッチはaction: "add"で/audiences/updateに送信され、バッチ1の上に追加されます。ソースセグメントから外れたメンバーは、セグメントや以前のメンバーシップの規模に関わらず、実際に削除されます — 単に古いまま残されるわけではありません。 |
オーディエンスのインデックス作成とは、メンバーシップのプッシュ(追加、削除、または置換)をライブオーディエンスに反映するBatchの非同期処理です。すべての/audiences/{update,replace,create}呼び出しは非同期であり、indexing_tokenを返します。すべてのバッチが送信された後、コネクタは収集したすべてのトークンについてGET /audiences/viewをポーリングし、それぞれが終端のindexing_state(APPLIEDまたはREPLACED)に達するか、indexing_timeout_secsが経過するまで続けます。replaceモードでは、バッチ1のreplaceトークンは、追加継続バッチが送信される前に、さらに完了までポーリングされます。これにより、非同期の消去処理が競合して、追加されたばかりの継続バッチを消去することを防ぎます。このバリアはindexing_timeout_secs: 0の場合はスキップされます。
この例では、ネイティブ属性(メール、言語、地域)とカスタム属性(サインアップ日、プロファイルURL、ロイヤルティ階層)を含む顧客プロファイルをエクスポートします。
SELECT
  customer_id          AS identifier__custom_id,
  email                AS batch__email_address,
  marketing_consent    AS batch__email_marketing,
  phone                AS batch__phone_number,
  preferred_language   AS batch__language,
  timezone             AS batch__timezone,
  country_code         AS batch__region,
  CAST(signup_ts AS VARCHAR) AS date__signup_date,
  profile_url          AS url__profile_url,
  loyalty_tier,
  interests            AS string_array__interests,
  preferences_json     AS object__preferences
FROM customer_profiles
WHERE TD_TIME_RANGE(time, TD_DATE_TRUNC('day', TD_SCHEDULER_TIME() - 86400, 'UTC'), NULL)
サンプルクエリ結果
| identifier__custom_id | batch__email_address | batch__language | batch__region | loyalty_tier |
|---|---|---|---|---|
| abc123 | user@example.com | en | FR | gold |
| def456 | jane@example.com | fr | fr | silver |
これは1つのPOST /2.11/profiles/mass-updateリクエストを生成します。各行は、identifiers.custom_idブロックと、$email_address、$language、$region、date(signup_date)、url(profile_url)、loyalty_tierワイヤキーを使用するattributesオブジェクトを持つ1つの操作になります。batch__regionの値frはFRに正規化されます。
必要な設定
| パラメータ | 値 |
|---|---|
target | Profile |
profile_sync_type | Attributes |
skip_invalid_records | true |
omit_null_fields | true |
この例では、Eventsモードで行ごとに1つの購入イベントを記録します。batch__name列は必須です。イベントは各識別子の下にグループ化されます。
SELECT
  customer_id          AS identifier__custom_id,
  'purchase'           AS batch__name,
  CAST(purchased_at AS VARCHAR) AS batch__time,
  product_category     AS category,
  order_amount         AS amount
FROM purchases
WHERE TD_TIME_RANGE(time, TD_DATE_TRUNC('day', TD_SCHEDULER_TIME() - 86400, 'UTC'), NULL)
サンプルクエリ結果
| identifier__custom_id | batch__name | batch__time | category | amount |
|---|---|---|---|---|
| abc123 | purchase | 2026-06-21T10:00:00Z | electronics | 299 |
| abc123 | purchase | 2026-06-21T14:30:00Z | books | 42 |
両方の行はcustom_id abc123を共有しているため、events[]配列に2つのエントリを持つ1つの操作にグループ化されます。categoryとamount列はevents[].attributesの下のイベント属性になります。
必要な設定
| パラメータ | 値 |
|---|---|
target | Profile |
profile_sync_type | Events |
skip_invalid_records | true |
Batchはサーバー側でbatch__timeに24時間の recency ウィンドウを適用します。イベントは最大24時間前まで可能で、未来であってはなりません。スケジュールされた同期では、イベントのタイムスタンプがデータの論理的な日付ではなく、コネクタの実行時刻の過去24時間以内に収まるようにしてください。batch__timeを省略すると、Batchがリクエスト到着時刻をスタンプします。
この例では、プロファイルを更新する代わりに、Treasure AIのセグメントメンバーシップをBatchオーディエンスにプッシュします。マッピング、同期モード、インデックス作成の動作については、Audience固有の注意事項、オーディエンス同期モード、オーディエンスのインデックス作成とポーリングを参照してください。
SELECT
  customer_id       AS identifier__id,
  CAST(signup_ts AS VARCHAR) AS date__signup_date,
  loyalty_tier
FROM customers
WHERE segment = 'vip'
サンプルクエリ結果
| identifier__id | date__signup_date | loyalty_tier |
|---|---|---|
| abc123 | 2024-01-01T00:00:00Z | gold |
| def456 | 2024-02-15T00:00:00Z | silver |
これは1つのPOST /2.11/audiences/replaceリクエストを生成します(複数バッチにわたる大規模なセグメントの場合は、1つの/audiences/replaceリクエストの後に1つ以上の/audiences/updateリクエストが続きます)。各行は1つのids[]エントリになります:{"id": "abc123", "attributes": {"date(signup_date)": "2024-01-01T00:00:00Z", "loyalty_tier": "gold"}}。
必要な設定
| パラメータ | 値 |
|---|---|
target | Audience |
audience_name | vip_customers |
audience_sync_mode | replace |
create_audience_if_not_exists | true |
audience_type | custom_ids |
skip_invalid_records | true |
Scheduled JobsとResult Exportを使用して、出力結果を定期的にBatchに書き込むことができます。
Treasure AIのスケジューラ機能は、高可用性を実現するための定期的なクエリ実行をサポートしています。
Scheduled Jobs と Result Export を使用して、指定したターゲット宛先に出力結果を定期的に書き込むことができます。
Treasure Data のスケジューラー機能は、高可用性を実現するために定期的なクエリ実行をサポートしています。
2 つの仕様が競合するスケジュール仕様を提供する場合、より頻繁に実行するよう要求する仕様が優先され、もう一方のスケジュール仕様は無視されます。
例えば、cron スケジュールが '0 0 1 * 1' の場合、「月の日」の仕様と「週の曜日」が矛盾します。前者の仕様は毎月 1 日の午前 0 時 (00:00) に実行することを要求し、後者の仕様は毎週月曜日の午前 0 時 (00:00) に実行することを要求するためです。後者の仕様が優先されます。
Data Workbench > Queries に移動します
新しいクエリを作成するか、既存のクエリを選択します。
Schedule の横にある None を選択します。
ドロップダウンで、次のスケジュールオプションのいずれかを選択します:
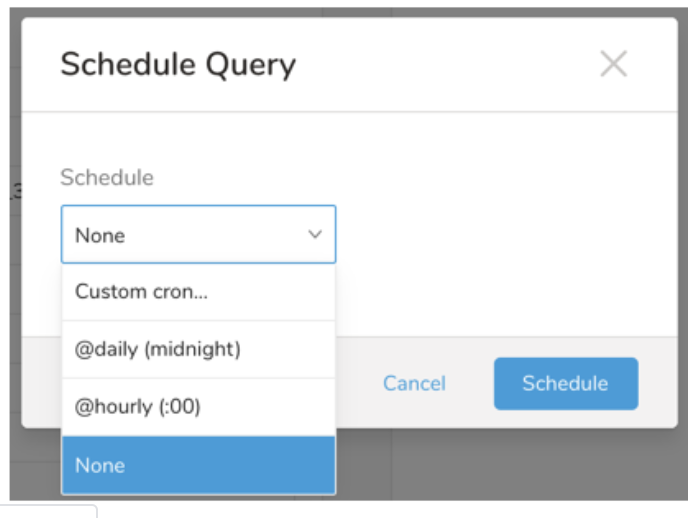
ドロップダウン値 説明 Custom cron... Custom cron... の詳細を参照してください。 @daily (midnight) 指定されたタイムゾーンで 1 日 1 回午前 0 時 (00:00 am) に実行します。 @hourly (:00) 毎時 00 分に実行します。 None スケジュールなし。
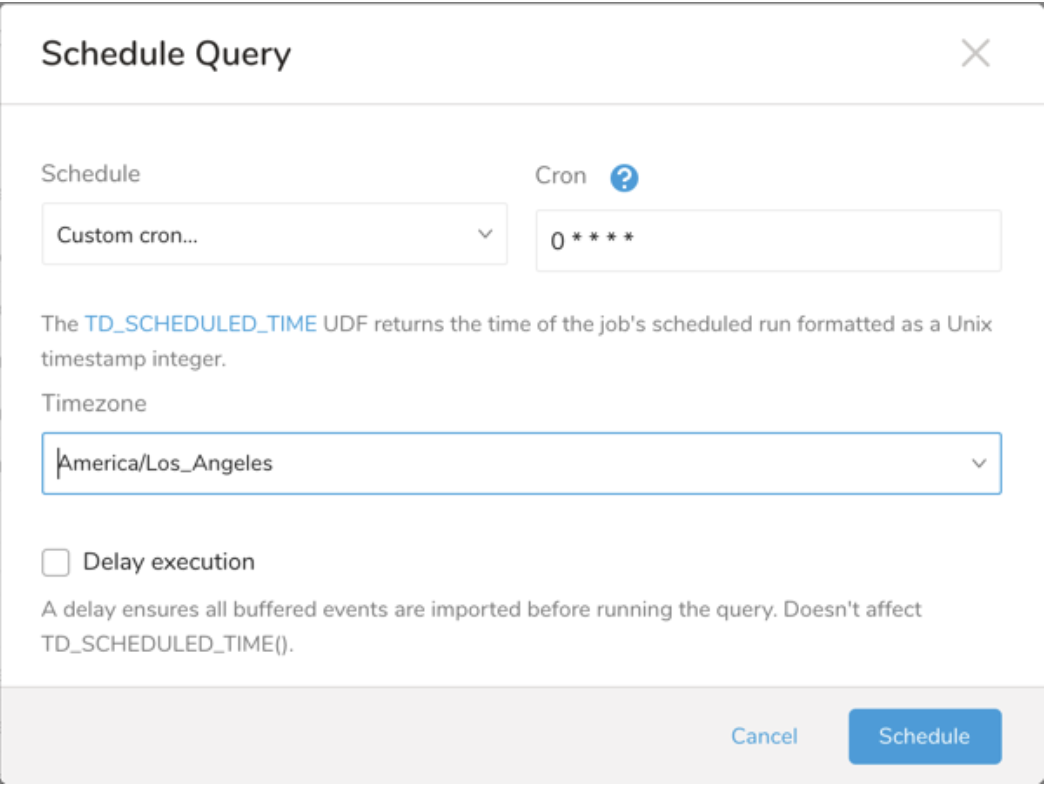
| Cron 値 | 説明 |
|---|---|
0 * * * * | 1 時間に 1 回実行します。 |
0 0 * * * | 1 日 1 回午前 0 時に実行します。 |
0 0 1 * * | 毎月 1 日の午前 0 時に 1 回実行します。 |
| "" | スケジュールされた実行時刻のないジョブを作成します。 |
 *    *    *    *    *
 -    -    -    -    -
 |    |    |    |    |
 |    |    |    |    +----- day of week (0 - 6) (Sunday=0)
 |    |    |    +---------- month (1 - 12)
 |    |    +--------------- day of month (1 - 31)
 |    +-------------------- hour (0 - 23)
 +------------------------- min (0 - 59)
次の名前付きエントリを使用できます:
- Day of Week: sun, mon, tue, wed, thu, fri, sat.
- Month: jan, feb, mar, apr, may, jun, jul, aug, sep, oct, nov, dec.
各フィールド間には単一のスペースが必要です。各フィールドの値は、次のもので構成できます:
| フィールド値 | 例 | 例の説明 |
|---|---|---|
| 各フィールドに対して上記で表示された制限内の単一の値。 | ||
フィールドに基づく制限がないことを示すワイルドカード '*'。 | '0 0 1 * *' | 毎月 1 日の午前 0 時 (00:00) に実行するようにスケジュールを設定します。 |
範囲 '2-5' フィールドの許可される値の範囲を示します。 | '0 0 1-10 * *' | 毎月 1 日から 10 日までの午前 0 時 (00:00) に実行するようにスケジュールを設定します。 |
カンマ区切りの値のリスト '2,3,4,5' フィールドの許可される値のリストを示します。 | 0 0 1,11,21 * *' | 毎月 1 日、11 日、21 日の午前 0 時 (00:00) に実行するようにスケジュールを設定します。 |
周期性インジケータ '*/5' フィールドの有効な値の範囲に基づいて、 スケジュールが実行を許可される頻度を表現します。 | '30 */2 1 * *' | 毎月 1 日、00:30 から 2 時間ごとに実行するようにスケジュールを設定します。 '0 0 */5 * *' は、毎月 5 日から 5 日ごとに午前 0 時 (00:00) に実行するようにスケジュールを設定します。 |
'*' ワイルドカードを除く上記の いずれかのカンマ区切りリストもサポートされています '2,*/5,8-10' | '0 0 5,*/10,25 * *' | 毎月 5 日、10 日、20 日、25 日の午前 0 時 (00:00) に実行するようにスケジュールを設定します。 |
- (オプション) Delay execution を有効にすることで、クエリの開始時刻を遅延させることができます。
クエリに名前を付けて保存して実行するか、単にクエリを実行します。クエリが正常に完了すると、クエリ結果は指定された宛先に自動的にエクスポートされます。
設定エラーにより継続的に失敗するスケジュールジョブは、複数回通知された後、システム側で無効化される場合があります。
(オプション) Delay execution を有効にすることで、クエリの開始時刻を遅延させることができます。
Audience Studio で activation を作成することで、segment データをターゲットプラットフォームに送信することもできます。
- Audience Studio に移動します。
- parent segment を選択します。
- ターゲット segment を開き、右クリックして、Create Activation を選択します。
- Details パネルで、Activation 名を入力し、前述の Configuration Parameters のセクションに従って activation を設定します。
- Output Mapping パネルで activation 出力をカスタマイズします。
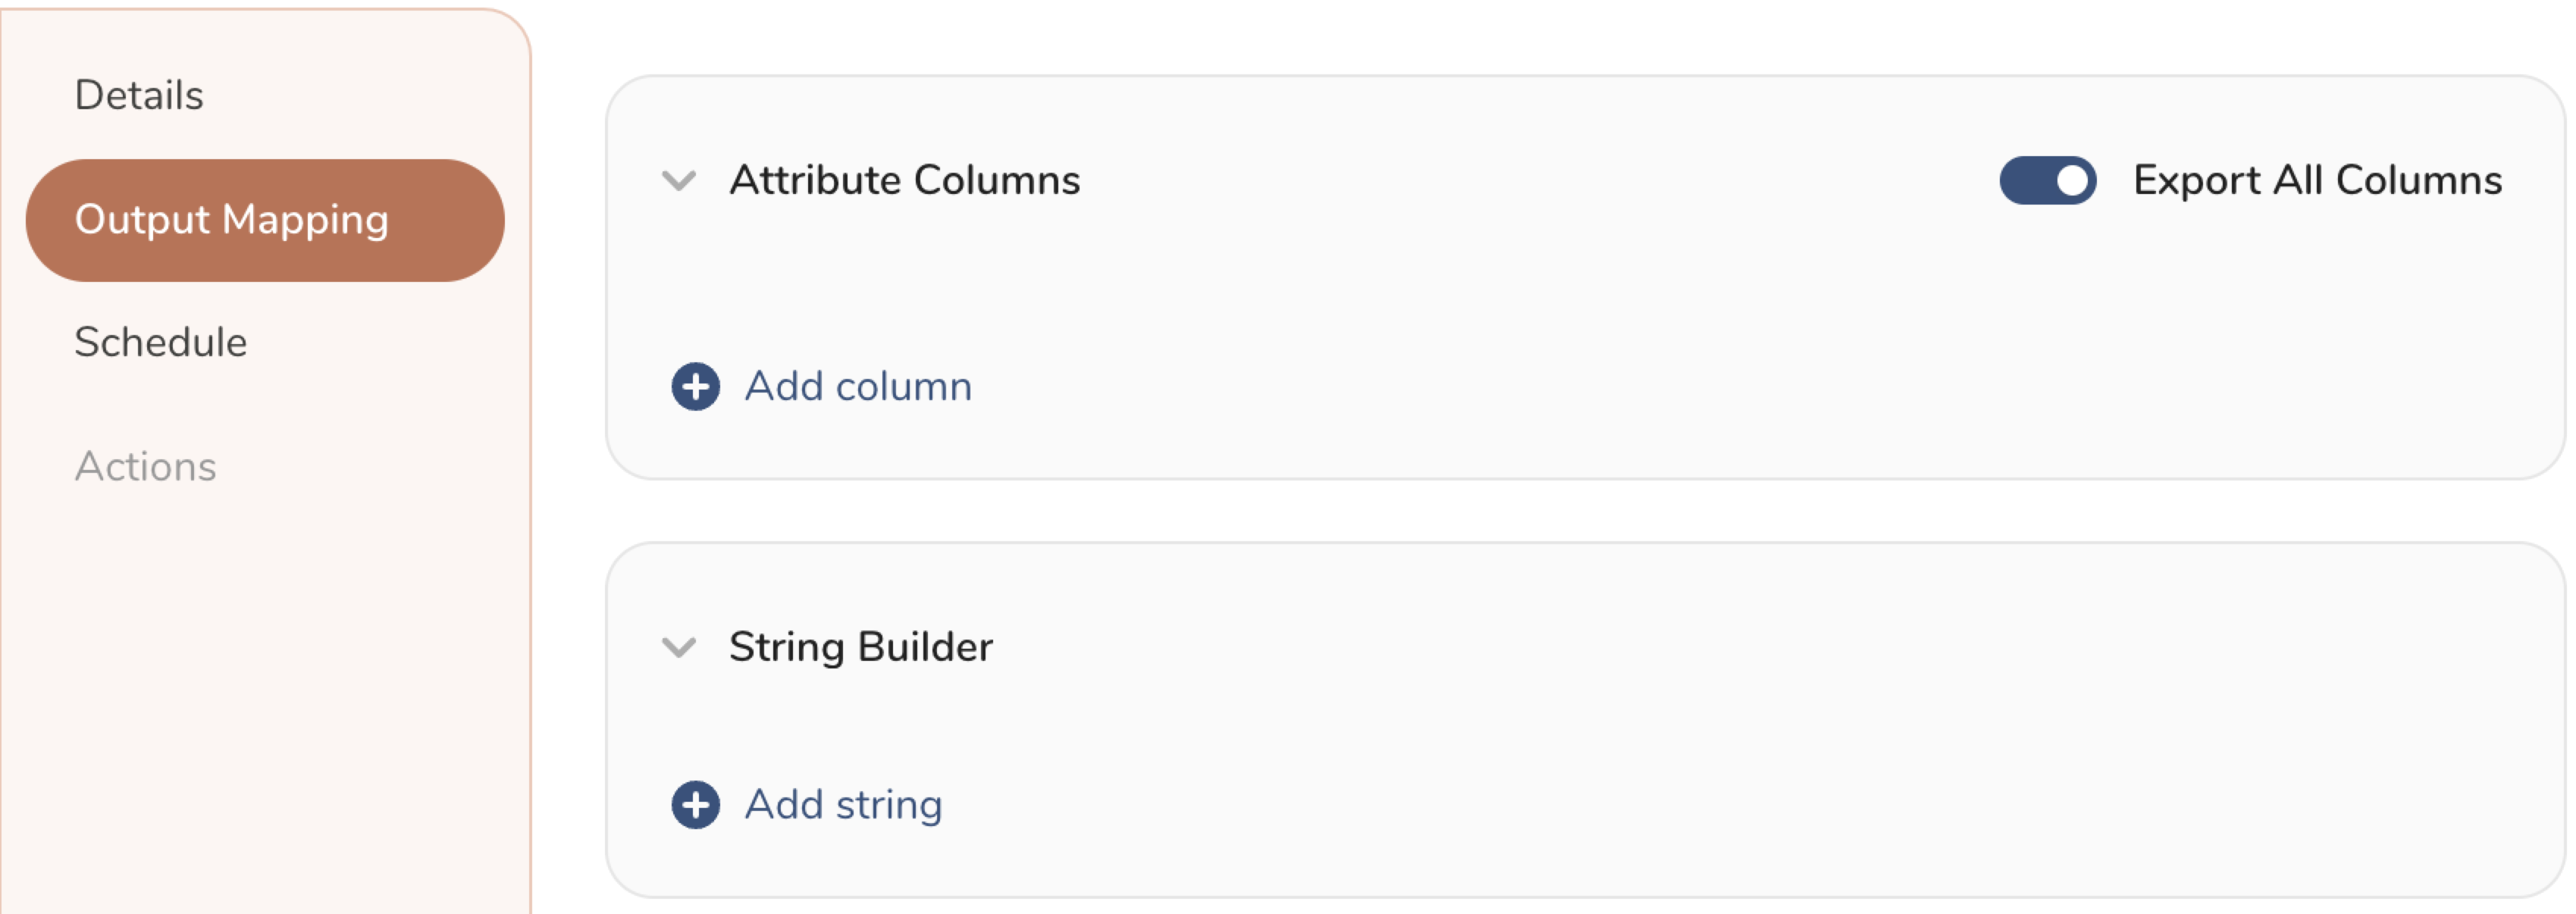
- Attribute Columns
- Export All Columns を選択すると、変更を加えずにすべての列をエクスポートできます。
- + Add Columns を選択して、エクスポート用の特定の列を追加します。Output Column Name には、Source 列名と同じ名前があらかじめ入力されます。Output Column Name を更新できます。+ Add Columns を選択し続けて、activation 出力用の新しい列を追加します。
- String Builder
- + Add string を選択して、エクスポート用の文字列を作成します。次の値から選択します:
- String: 任意の値を選択します。テキストを使用してカスタム値を作成します。
- Timestamp: エクスポートの日時。
- Segment Id: segment ID 番号。
- Segment Name: segment 名。
- Audience Id: parent segment 番号。
- + Add string を選択して、エクスポート用の文字列を作成します。次の値から選択します:
- Schedule を設定します。
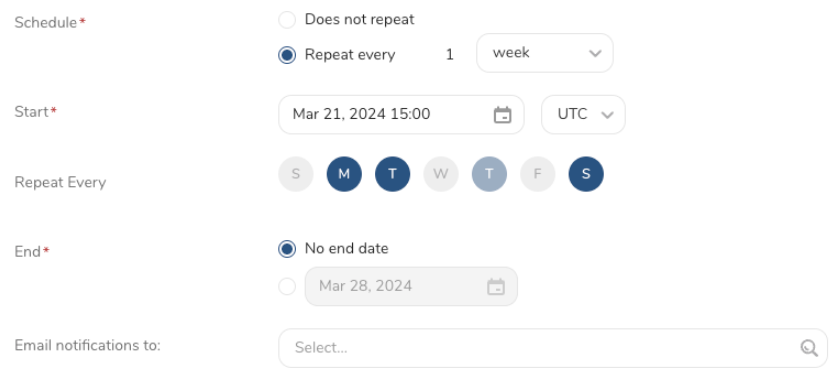
- スケジュールを定義する値を選択し、オプションでメール通知を含めます。
- Create を選択します。
batch journey の activation を作成する必要がある場合は、Creating a Batch Journey Activation を参照してください。
Treasure Workflow内で、データコネクタを使用してデータをエクスポートするように指定できます。
詳細はUsing Workflows to Export Data with the TD Toolbeltを参照してください。
サンプルワークフロー設定
timezone: UTC

_export:
  td:
    database: sample_datasets

+td-result-into-batch:
  td>: queries/batch_export.sql
  result_connection: batch
  result_settings:
    target: Profile
    profile_sync_type: Attributes
    batch_size: 10000
    skip_invalid_records: true
    ignore_partial_errors: true
omit_null_fields: true| エラーまたは症状 | 原因 | 解決策 |
|---|---|---|
認証が401で失敗する。 | rest_api_keyまたはproject_keyが正しくないか、認証情報がプロジェクトへのアクセス権を持っていません。 | BatchコンソールのSettingsでREST APIキーとプロジェクトキーを確認してください。 |
設定時に「unknown Batch native attribute」でエクスポートが失敗する(target: Profile)。 | batch__列がサポートされていないネイティブ属性のサフィックスを使用しているか、間違ったモードで使用されています(例:Eventsモードでのプロファイルネイティブ名)。 | サポートされているネイティブ属性名を確認し、profile_sync_typeと一致することを確認してください。batch__topic_preferences__addのような増分形式はサポートされていません。 |
識別子列が存在しないためエクスポートが失敗する(target: Profile)。 | クエリにidentifier__custom_idもinstallation列もないか、両方の識別子形式が含まれています。 | 正確に1つの識別子形式を指定してください:identifier__custom_id、またはidentifier__apikeyとidentifier__installation_idの組み合わせ。 |
識別子列が正しくないためエクスポートが失敗する(target: Audience)。 | クエリにidentifier__id列がないか、Profileの識別子サフィックス(identifier__custom_id、identifier__apikey、identifier__installation_id)を使用しているか、batch__列やコンテナプレフィックス付き(string_array__/object__/array__)の列が含まれています。これらはオーディエンスモードでは許可されていません。 | 正確に1つのidentifier__id列を指定し、date__、url__、またはプレーンなカスタム属性の列のみを使用してください。 |
| カスタムキーエラーでエクスポートが失敗する。 | カスタム属性の列名が小文字化した後でも^[a-z0-9_]{1,30}$に一致しません(例:ハイフンやドットを含む、または30文字を超える)。名前は自動的に小文字化されるため、大文字だけではこのエラーは発生しません。 | クエリで列を、小文字・数字・アンダースコアのみを使用した30文字以下の名前にエイリアスしてください。 |
| 行がスキップされる。 | 行がクライアント側の検証に失敗し(例:無効なメール形式、または25 kBを超える属性オブジェクト)、skip_invalid_recordsがtrueです。 | ジョブログで行インデックス、列、ルールを確認し、ソースデータを修正してください。行をスキップする代わりにエクスポートを失敗させるには、skip_invalid_recordsをfalseに設定します。 |
| エクスポートがレート制限される。 | Batchが429 Too Many Requestsを返しました。 | 対応は不要です。コネクタは少なくとも5秒待機し、自動的に再試行します。 |
BatchがSUCCESS_WITH_PARTIAL_ERRORSを返す(target: Profile)。 | Batchはリクエストを受け入れましたが、一部のレコードを拒否しました。 | ジョブログでレコードごとの診断情報(bulk index、category、attribute、reason)を確認し、ソースデータを修正してください。部分エラー発生時にエクスポートを失敗させるには、ignore_partial_errorsをfalseに設定します。 |
オーディエンスが存在しないためエクスポートジョブが失敗する(target: Audience)。 | create_audience_if_not_existsがfalseで、指定されたaudience_nameのオーディエンスがまだBatchに存在しません。 | create_audience_if_not_existsをtrueに設定してジョブにオーディエンスを自動的に作成させるか、先にBatchでオーディエンスを作成してください。 |
「indexing did not complete within N s」でエクスポートが失敗する(target: Audience)。 | Batchの非同期インデックス作成がAPPLIED/REPLACEDに達するまでにindexing_timeout_secsよりも長くかかりました。 | indexing_timeout_secsを増やすか、0に設定してインデックス作成の確認を待たずに成功を報告してください。 |